¿Por qué la IA acierta en el laboratorio y falla en la clínica?
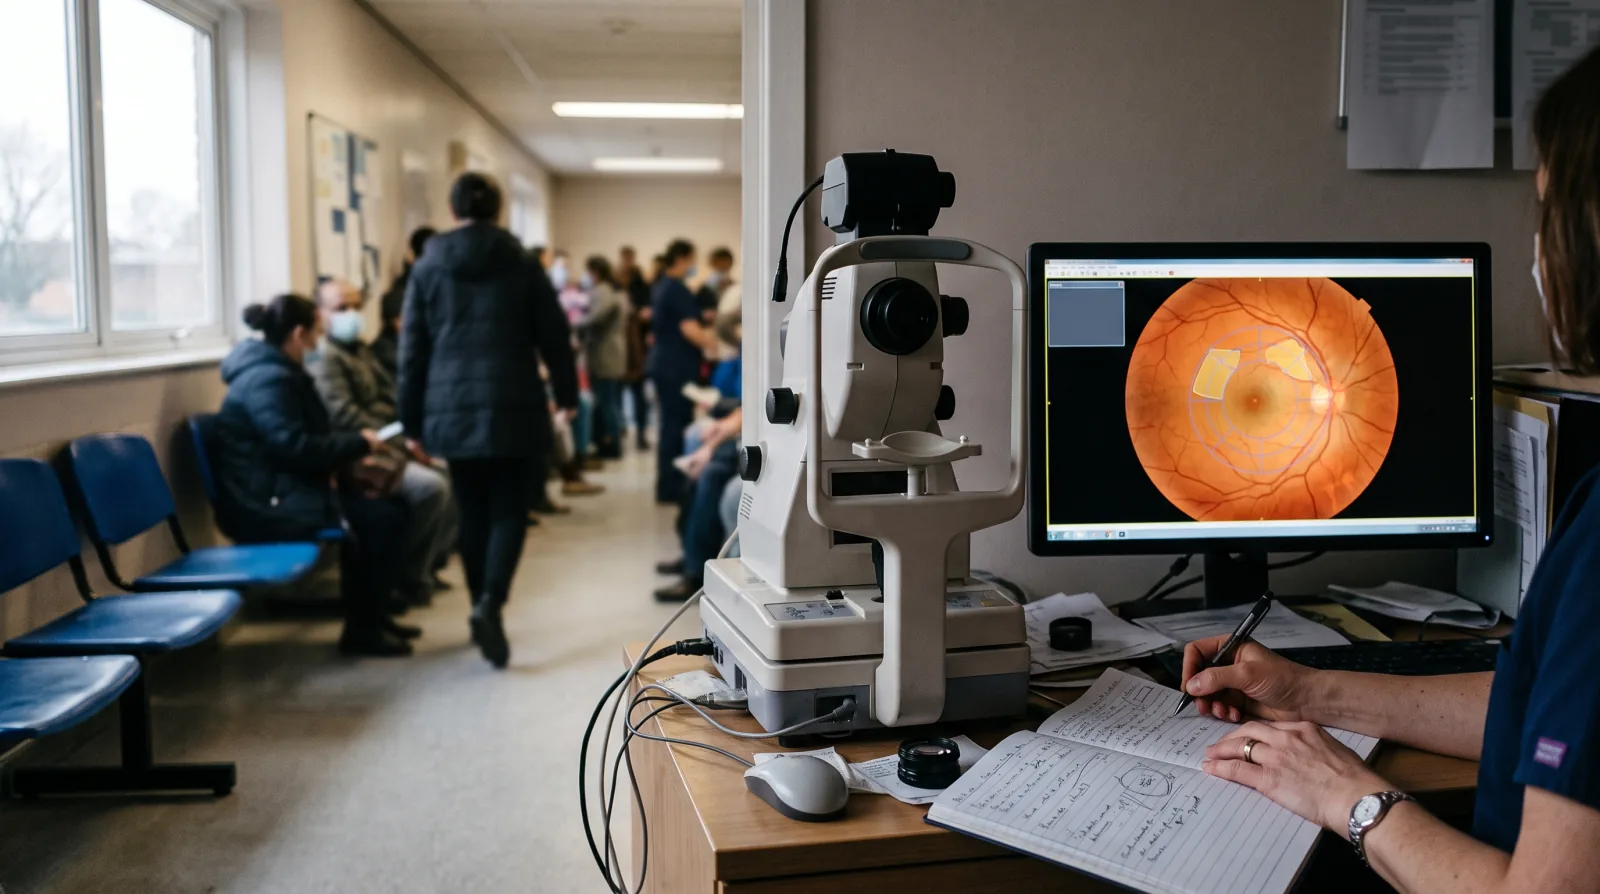
El 10 de septiembre de 2026, la revista Nature Medicine publicó el balance de un experimento que llevaba diez meses en marcha. Un equipo de la Universidad de Tsinghua y del Hospital Tsinghua Changgung, en Beijing, había metido agentes de inteligencia artificial en una clínica de ojos de verdad, con pacientes de verdad, desde noviembre de 2025. Cinco agentes: uno ordena los síntomas antes de la consulta, otro decide quién pasa primero, otro lee las imágenes de la retina, otro ayuda al médico a decidir y otro explica el diagnóstico al paciente y le hace seguimiento.
La IA que lee imágenes alcanzó una precisión de 0,93, comparable a los mejores sistemas del mundo. Y aquí viene el dato que hizo que la noticia diera la vuelta al planeta: al quinto mes, los médicos la usaron en 41 de 1.113 exploraciones. El 3,8 %.
Un mes después, el uso saltó al 23 %. No cambiaron el algoritmo. Cambiaron el número de clics.
Llevo años trabajando con modelos de aprendizaje automático y, confieso, esa historia me resulta familiar hasta el cansancio. Pero me obligó a ponerme una pregunta que casi nunca se hace en voz alta: ¿por qué una IA que acierta en el laboratorio falla cuando la ponen a trabajar?
La respuesta tiene tres capas, y la última no tiene nada que ver con inteligencia.
¿Qué significa que una IA «acierta el 93 %»?
Significa, en este caso, que si le muestras un ojo enfermo y un ojo sano, el 93 % de las veces le da más puntaje al enfermo. Esa medida se llama AUROC y es la que usan casi todos los estudios de IA médica. Un 0,5 es lanzar una moneda. Un 1,0 es no fallar nunca.
Piensa en un examen de admisión. El estudiante que saca 93 sobre 100 es bueno, sin duda. Pero el examen lo escribió alguien con el mismo libro con el que el estudiante estudió, en un salón silencioso, con tiempo de sobra y las preguntas bien impresas. La nota mide cuánto aprendió de ese libro. No mide qué hace un martes a las cuatro de la tarde, con la fila llena, la luz mala y un paciente que no sabe explicar qué le pasa.
Lo mismo con la IA. La cifra de 0,93 se mide sobre un conjunto de imágenes que el modelo nunca vio, sí, pero que fueron tomadas con las mismas cámaras, en las mismas condiciones y etiquetadas por las mismas personas que las de entrenamiento. Es un examen honesto sobre el libro. No es la vida.
¿Por qué el mundo real no se parece al laboratorio?
Porque los datos cambian y el modelo no se entera. En mi campo eso tiene nombre, cambio de distribución, y es la causa número uno de que un modelo brillante se vuelva mediocre al salir de la oficina.
El caso más famoso lo vivió Google en 2020. Su sistema para detectar retinopatía diabética, una complicación de la diabetes que deja ciega a la gente, tenía más del 90 % de precisión en el laboratorio, «nivel de especialista». Lo llevaron a 11 clínicas de Tailandia. Allá las enfermeras fotografiaban docenas de pacientes a toda velocidad, con luz pobre, y el sistema rechazó más de una de cada cinco fotos por calidad insuficiente. Internet era tan lento que subir una imagen tardaba entre 60 y 90 segundos. Una enfermera lo resumió: «en las dos primeras horas solo pudimos revisar 10 pacientes».
Eso lo documentó el propio equipo de Google, encabezado por Emma Beede, en un estudio de 2020.
Es como aprender a manejar en un simulador con carreteras secas y soleadas, y salir a la Autopista Norte un viernes con aguacero. El conductor no se volvió peor. El mundo se volvió distinto.
En Beijing pasó algo parecido, pero con las etiquetas. El modelo se había entrenado con casi 27.000 imágenes, muchas de baja calidad y con diagnósticos inconsistentes. Cuando las cambiaron por apenas 1.426 imágenes revisadas y etiquetadas una por una por oftalmólogos expertos, la precisión subió y los falsos positivos bajaron. Veinte veces menos datos, mejor resultado.
Si estudias con un solucionario que tiene errores, no importa cuántos ejercicios hagas: aprendes los errores. Ya lo escribí cuando expliqué qué es un algoritmo estadístico y por qué la IA no es tan inteligente como parece: el modelo no sabe nada que no esté en sus datos, y si los datos mienten, el modelo miente con confianza.
¿Y si el problema no es que se equivoque?
Aquí está el giro, y a mí me parece el más importante de los tres. En Tsinghua, con el modelo ya reentrenado y acertando el 93 %, los médicos lo usaron en el 3,8 % de las consultas. La IA no estaba fallando. Estaba siendo ignorada.
La razón, cuando la buscaron, fue vergonzosamente mundana: la herramienta pedía demasiados clics y demasiados datos escritos a mano. Un oftalmólogo ve decenas de pacientes al día. Treinta segundos extra por consulta son media hora al final de la jornada, todos los días, para siempre. Nadie paga ese precio por una segunda opinión que casi siempre coincide con la propia. Quitaron clics, redujeron lo que había que teclear, y el uso se multiplicó por seis, hasta el 23 %. El algoritmo era el mismo.
Es la receta perfecta que nadie cocina porque tarda cuarenta minutos y hay que lavar tres ollas. La receta no está mal. Está mal la cocina.
Y esto me lleva a la frase que quiero que te quede: una IA que nadie usa tiene precisión cero. No importa cuánto acierte en el papel. En una clínica, la precisión útil es la precisión multiplicada por las veces que alguien la consulta.
¿Qué pasa cuando la IA sí se usa y se equivoca?
Entonces pasa lo contrario, y es peor. Hay un modelo de predicción de sepsis, una infección generalizada que mata en horas, instalado en cientos de hospitales de Estados Unidos por la empresa que hace su historia clínica electrónica. El fabricante reportaba una precisión de entre 0,76 y 0,83. Cuando un equipo de la Universidad de Michigan lo puso a prueba con 38.455 hospitalizaciones propias y publicó los resultados en JAMA Internal Medicine en 2021, encontró 0,63.
El modelo detectó solo un tercio de los casos reales de sepsis y disparó alertas en el 18 % de las hospitalizaciones, cuando solo el 6,6 % tuvo sepsis. Ocho pacientes evaluados por cada caso verdadero.
Piensa en una alarma de carro que suena cada vez que pasa un camión. La primera semana sales a mirar. La tercera, ya no. Y la noche que sí se lo roban, la alarma suena igual que siempre. A eso los médicos le llaman fatiga de alertas, y es la forma más rápida de convertir una herramienta en ruido.
El equipo de Tsinghua encontró además un desajuste más sutil. Su IA prioriza lo que ve en las imágenes. Los médicos priorizan lo que el paciente cuenta. Dos formas legítimas de razonar que, puestas en el mismo consultorio sin acordar quién manda, se estorban.
¿Sabemos entonces si la IA ayuda a los pacientes? Todavía no
Con honestidad: el estudio de Beijing no lo mide. Reporta cuántas veces se usó la herramienta y cuánto acierta, no si algún paciente vio mejor, se diagnosticó antes o se ahorró una cirugía. Es una sola clínica, un solo hospital, seis meses de datos. Los propios autores lo presentan como «lecciones iniciales», no como veredicto, y así lo recogió la cobertura de ScienceAlert.
El panorama más amplio dice lo mismo. La agencia reguladora de Estados Unidos, la FDA, tenía autorizados 1.524 dispositivos médicos con IA a mitad de 2026. A mitad de 2024, Medicare, el seguro público más grande de ese país, pagaba por unos diez. Mil quinientos permisos, diez facturas. La distancia entre «aprobado» y «usado» es un abismo que casi nadie mide.
En mi opinión, y la marco como opinión: el cuello de botella de la IA médica ya no es el modelo. Hace cinco años lo era. Hoy los modelos son buenos y baratos, y lo que escasea es lo aburrido: datos bien etiquetados, interfaces que no estorben, alguien que verifique afuera del fabricante y un médico que tenga tiempo de mirar. Si quieres una guía para no comprar humo, sirve la misma que para saber si una noticia de ciencia es falsa: pregunta quién lo midió, con qué datos y si alguien ajeno lo repitió.
Qué puedes hacer tú, hoy
No hace falta ser médico ni programador para usar esto. Son tres preguntas que sirven para cualquier IA que te vendan, en una clínica, en tu empresa o en tu teléfono.
- ¿Con qué datos se probó? Si la respuesta es «con los nuestros», la cifra de precisión vale para su laboratorio, no para tu hospital, tu ciudad ni tu cámara. Pide una validación externa, hecha por alguien que no cobre por venderla.
- ¿Cuántos clics cuesta usarla? Mídelo. Si añade más de un minuto a cada tarea, la gente dejará de usarla en un mes, por buena que sea. El 3,8 % de Tsinghua es la prueba.
- ¿Qué pasa cuando se equivoca? Toda herramienta falla. La pregunta es si el error se nota, si alguien lo revisa y si el sistema aprende de él. Una IA sin un humano que la contradiga no es un asistente: es una alarma de carro.
Y si eres paciente en Latinoamérica, hay una razón para seguir este tema con interés y sin miedo. En México hay 4.213 oftalmólogos registrados y casi un tercio vive en Ciudad de México; fuera de la capital quedan unos dos por cada 100.000 habitantes, para un país con más de 15 millones de adultos con diabetes. Ahí una IA que lea retinas bien, con una cámara barata y una enfermera entrenada, no reemplaza a nadie. Llega donde no hay nadie.
Los que etiquetan las 1.426 imágenes
La parte de esta historia que no sale en los titulares es la más humana. Detrás del salto de precisión en Beijing hay oftalmólogos que se sentaron a revisar 1.426 imágenes una por una, con nombre y apellido de cada enfermedad, para que una máquina dejara de aprender basura. Detrás del fracaso en Tailandia hay enfermeras que retomaban las fotos rechazadas mientras la fila crecía, y un equipo de Google, con Emma Beede al frente, que tuvo la honestidad de publicar que su sistema no servía como estaba.
Detrás del modelo de sepsis hay un grupo en Michigan que se tomó el trabajo de contar 38.455 hospitalizaciones para decirle a cientos de hospitales que la alarma que compraron sonaba mal.
En nuestra región ya hay gente en esa misma trinchera: equipos en Chile validando su propio sistema de tamizaje de retinopatía en el sistema público, y grupos en México probando modelos con datos del seguro social, con las cámaras y la luz que hay, no con las ideales.
Nada de eso es glamuroso. Es trabajo de hormiga con datos, clics y pacientes. Pero es exactamente lo que separa una IA que acierta en un artículo de una IA que le devuelve la vista a alguien en un pueblo sin oftalmólogo.
¿Y tú? ¿Cuál fue la última herramienta «inteligente» que te instalaron en el trabajo y dejaste de usar a la semana? Cuéntamelo, que esa historia también es ciencia.
¿Te gustó esta entrada? Apóyame con un café ☕